惭愧啊惭愧,难得测了回Claude Code,闹了个大笑话
测错了模型,其实glm挺不错的

惭愧
昨天的文章,用 Claude Code 做了三轮测试,做完后就急着把文章写完,然后就去睡觉了。早晨起来才想起应该看看 sonnet 模型消耗了我多少钱,结果一看傻眼了,一分钱没少。我仔细查了用量明细,测试期间确实没有调用记录。难道我整个测试用的都是 glm?
先说结论,由于环境变量配置的问题,上篇文章中的测试实际使用的均是智普官网 Lite 订阅的 glm-4.7,只不过恰巧第三轮测试的效果非常好,bug极少,样式也还不错,让我真的相信它就是 sonnet 了。
也就是说 glm 的能力上限比我昨天看到的要好,这么看前两轮总是中断,或许就是智普服务的问题了,而不是模型本身的问题,这个还得再测测。
因为测试时打算使用不同的接口和模型,所以我是直接在启动命令前设置了环境变量,误以为这样设置的环境变量优先级会高于配置文件的。
ANTHROPIC_AUTH_TOKEN=sk-or-v1-0a00201fd77654d3e4ed37d8373abf5e008afa03a542e5239ac6fcac42e1c09 ANTHROPIC_BASE_URL=https://openrouter.ai/api ANTHROPIC_DEFAULT_SONNET_MODEL=anthropic/claude-sonnet-4.5 ANTHROPIC_DEFAULT_OPUS_MODEL=anthropic/claude-opus-4.5 ANTHROPIC_DEFAULT_HAIKU_MODEL=anthropic/claude-haiku-4.5 claude
虽然也有不少软件会优先使用这种临时设置的环境变量,但 Claude Code 则选择优先使用配置文件中的设置,于是我的三轮测试用的都是同一个始终如一的配置文件,也就是配了智普官网接口和 key的配置文件。
其实启动 Claude Code 后我也怕配错,进行了验证,但我的验证方法是直接问它你是什么模型,可 Claude Code 是把你配置的模型放到系统提示词里了,所以它总是会回答自己是你配的模型,而不是它实际的模型。
英伟达的接口因为不兼容,还用 LiteLLM 中转了一下,要是当时看眼 LiteLLM 的日志其实也能发现。不过既然已经出问题了,我就把没测到的,再重新测一遍吧。这次我通过 OpenRouter 的用量明细,以及 LiteLLM 的日志,确认使用的模型没错了。
于是我现在有了五份测试:
- 昨天的三份都是用的智普官方的Lite订阅,模型是glm4.7,
- 第四轮测试是英伟达提供的免费 glm4.7,
- 第五轮测试用的是 OpenRouter 的 Sonnet4.5。
第四轮 英伟达 glm
英伟达的 glm 还是比较稳定,开发中就中断了一次。不过到最后测试环节时,上下文超限导致接口报错了,这个在其他测试中没遇到过。我执行了 /compact 命令压缩了上下文后,让它继续,倒也顺利完成了。
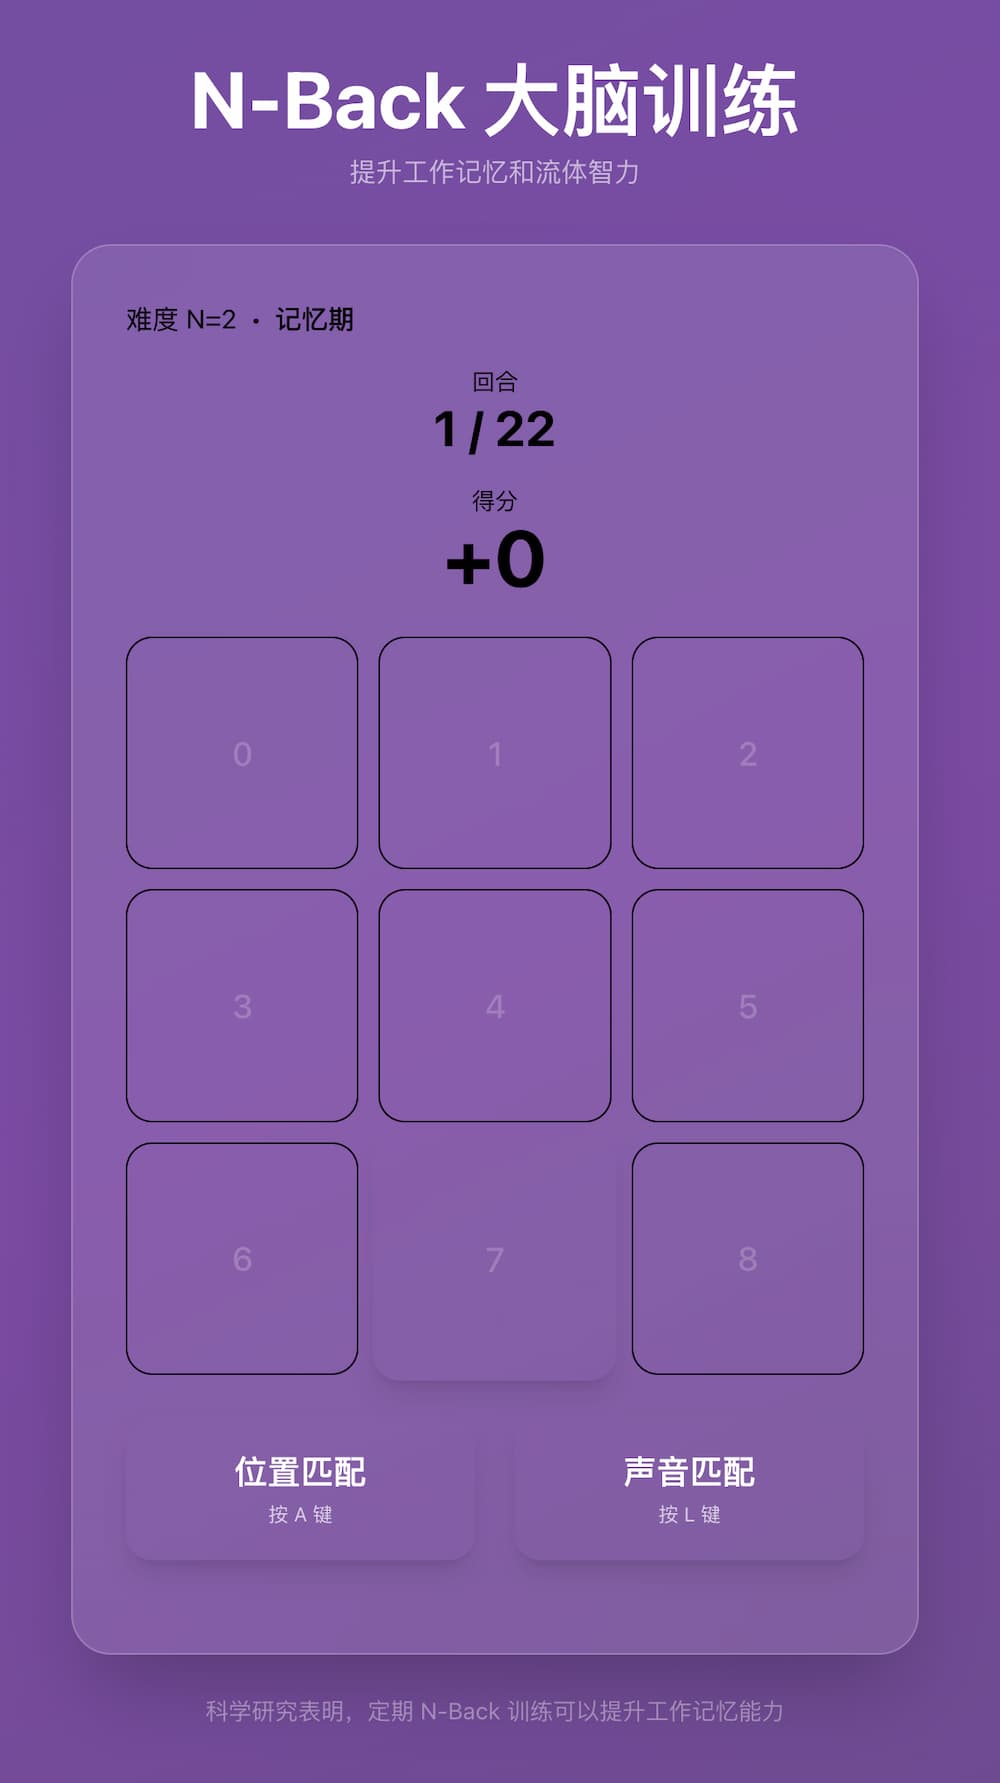
上面就是成品截图,也让它用 frontend-design 了,但这配色还有这黑线框实在没法说它好,一些交互和动画效果也不行,Bug 跟一二轮测试差不多。总体来说只是稳定性比智普强,看来智普的服务最近是有些问题。
第五轮 Claude Sonnet
Sonnet4.5 的测试一切都很顺利,中间没有中断,跑了足足38分钟。
但质量确实不如昨天第三轮,也有一些 bug,UI 倒也不算难看,可是整个页面把我的鼠标隐藏了,也是挺奇葩的,然后一些交互动画不太好,导致页面元素总在晃动。虽说都不难改,但确实不如昨天第三轮测试。
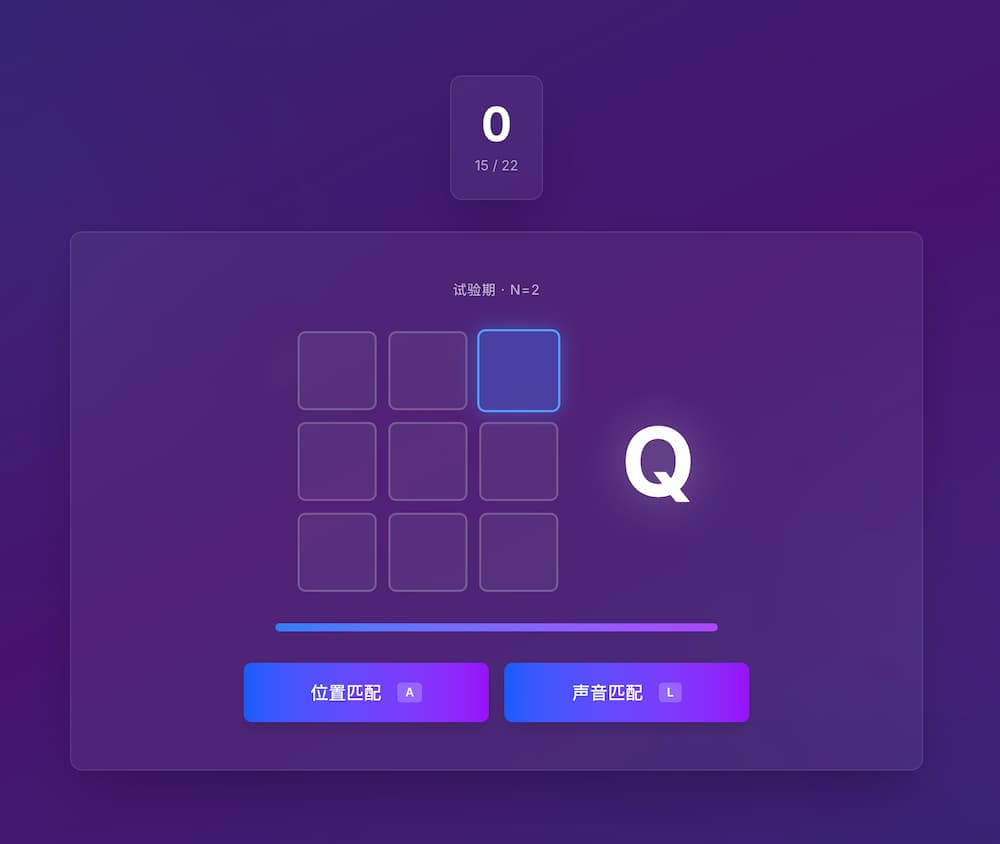
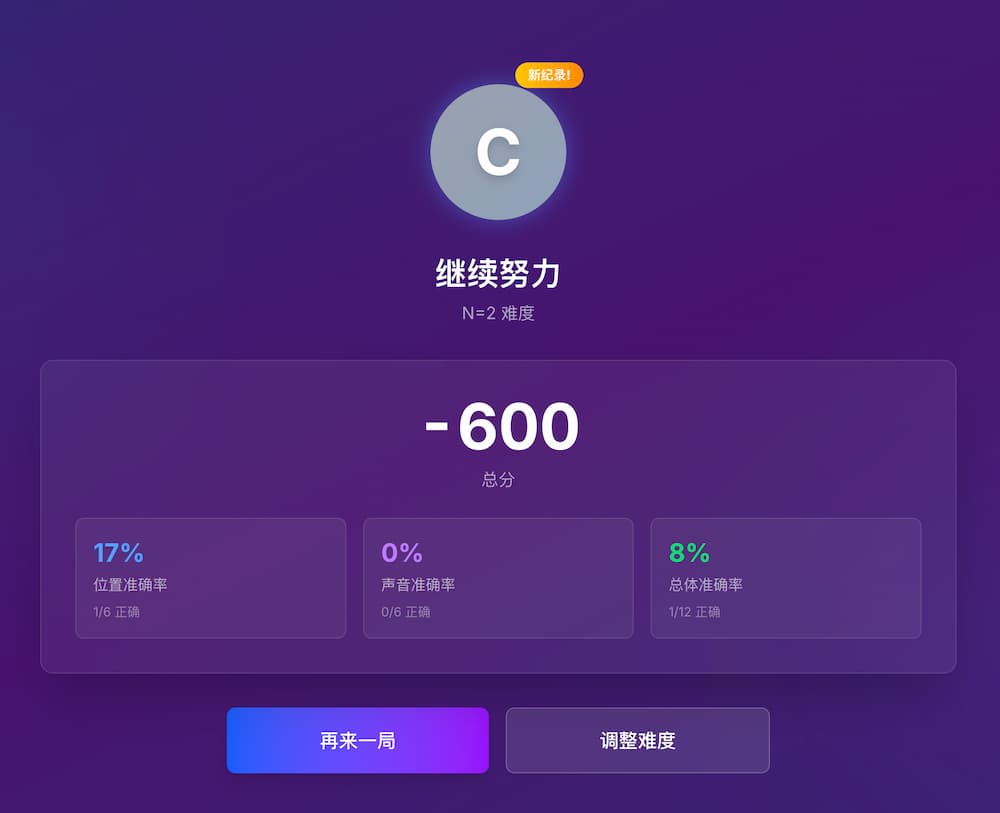
上面是成品截图,看着还行是吧。不过 sonnet 模型最大的问题就是贵,这个半个多小时,烧了我$7.5,一般场景我是真舍不得用啊。
所以还是想感慨下昨天的第三轮,完成度太高了,不能怪我没发现异常,只能说智普的 glm 上限还是挺高的,只是需要碰碰运气。
总结
最后综合一下,给这五轮测试打个分吧:
| 模型 | 稳定性 | 质量 | UI |
|---|---|---|---|
| 官方glm4.7 | ⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️ |
| 官方glm4.7 | ⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| 官方glm4.7 | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ |
| 英伟达glm4.7 | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️ |
| Sonnet4.5 | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
看看评分,我还是很在意 glm 的稳定性,于是等到晚上,应该是使用的低峰期了,我又测了几遍智普的 glm,基本上都是20分钟左右完成,并且没有中断,看来还是智普服务的问题。至于生成质量还是一般,跟一二四轮测试差不多。
那么总的来说,智普 glm 模型的水平比我昨天的结论还要更高一些了,就是服务稳定性可能近期会差些,输出质量也不稳定,那正常水平究竟如何,可能得长期观察下了。不过这么一来总体上还是推荐的,毕竟一年不到200的价格在那了,还是足够保底的。
我这个测试设计的比较随意,除了最开始的游戏规则,中间没再干预过。如果再优化下 PRD 和提示词,理论上效果还能更好些,但对于这个对比测试不是必要的。后面我自己正式开发,还是要研究下怎么优化的,后续再聊吧。