同一个Coding Plan群里,有人喊退款,有人抱怨买不到
看来看去,还是推荐 MiniMax

开工一个多礼拜了,各家算力还是非常紧张,好几家的用户群中都持续有人反馈接口限流、报错等问题,也发现了一些新情况,继续给大家更新一下信息。
更新下信息
MiniMax
我之前一直推荐 MiniMax 的订阅,因为它家是目前唯一没有周限额的,如果你要重度使用,尤其是有一些自动化流程的,那么 MiniMax 的订阅能提供的用量是远远高于其他家的。
尽管 MiniMax 的用户群中也有很多人反馈接口被限流,报错,生成质量差等问题,但目前来看他家的售后还算不错,大部分表述清晰的问题都有技术人员响应。甚至还开发了一个客服机器人来辅助解答问题,对那些不喜欢读文档的用户来说帮助很大。
MiniMax 最近还推出了 MaxClaw,也就是云端部署的小龙虾,而且从昨天开始,MaxClaw 的文本模型部分还可以使用 MiniMax 的 Coding Plan,而不用消耗积分了。当然,你还是得先买 MaxClaw。
关于模型质量我放到最后再一起说。总之,目前看 MiniMax 依然是众多订阅中最不坏的。我还是推荐买年度订阅,因为没准哪天就涨价或者加限额了。
智普
智普真是让人又爱又恨啊。用户群里每天都有两种消息在刷屏,一波是因为接口老报错,喊着退款投诉的,一波是因为每天10点抢不到订阅,骂他们饥饿营销的。一帮人想退,一帮人又抢不上,挺魔幻的。
然后客服也有点儿摆烂了,很少再响应用户的问题了,不过也可以理解,毕竟目前的问题已经不是客服可以解决的了。然后,昨天他们终于把退款的入口开发完了,于是客服也开始对相关的问题进行回复了。
看来智普最大的问题还是算力跟不上,所以根本不敢卖。可以退款的是那些没能第一时间用上 GLM-5 的,基本都是老套餐,退不了多少钱,但却能省下不少算力,所以退款对智普没什么坏处。反正要是我,我肯定不退款,那可是绝版套餐啊。
剩下就等着给我这种升级的用户“回滚”了,回滚的逻辑应该比退款复杂,估计开发上线最早也得下周了。祝他们一切顺利吧。
我这还有7张7天体验卡,扫下面的码可以领取,不过不能用 GLM-5。之前虽然每天10点的抢不到,但是据说用体验卡的人可以正常购买,接着就有人开始倒卖体验卡了,于是官方好像也堵住了这个缺口,大家都一样接受限购了。
Kimi
因为已经买了智普和 MiniMax 的订阅,所以 Kimi 的我一直没买。不过昨天用手机打开 Kimi 时,发现手机端(iPhone)购买订阅可以免费试用7天,电脑端好像是要花几块钱的,我一看就开个7天试试吧。
于是就看到了它的控制台,果然是有周限额。这是最低档订阅,用量给的不多,做了个练打字的小网站,5小时的额度就消耗了83%,周额度消耗了31%,这一天就能把一周的量用完。不过成品效果还可以,这个放最后一起说。
Kimi 有个限时的3倍额度,因为之前是限时,我觉得意义不大就没提,现在已经改成永久了,那这个量就还好。但是看我测试的情况,相比其他家量还是比较少,难道是因为按 token 计量导致的?
然后,我也没找到它的用户群,也没个客服啥的,有问题了不知道找谁问,倒是有个销售的联系方式。所以这个还是大家自己判断吧。
阿里云百炼
上周说了,阿里云百炼目前提供的模型最全了,谁家的都有,想做多模型对比测试的可以考虑。但是好多人都说阿里只给了自家 qwen 模型足够的算力,其他模型都特别慢。
我也去测了一下,没看出明显的算力偏袒,同样的任务 qwen 跑了一个多小时,minimax 只跑了27分钟,生成质量还挺高,而 glm 跑跑就断。所以单看时间也不算完全偏袒,不过感觉别家模型的质量不太稳定,具体可以参看后面测试结果。
看用量的话,相比上面同样是最低档,价格也差不多的 Kimi ,还是多了不少的。我用三个模型跑完三遍项目时,5小时的消耗也没超过50%,跑完四个项目时周额度只消耗了5%。
本来控制台上是有个用户的钉钉群的,但我扫码时群已经满了,再刷新页面,这个群的入口也没了,所以不太清楚他们用户反馈如何。
总之,阿里只有月度订阅,但首月很便宜,很适合做多模型的对比测试。
火山方舟
这个没什么好说的了,阿里添加了几乎所有家的模型,但方舟还是不为所动,依然没有 GLM-5 和 MiniMax,于是用户群里很多人抱怨,同样也有很多接口报错和限流的反馈。
似乎也有人在回应用户问题,但是不太明显,看不出是官方的还是热心网友。感觉火山方舟的订阅,除了比阿里少几个模型,就没什么区别了,完全没有优势了。
模型测试
最后说说我测试的结果吧。不算是个严谨的测试,就是随便写了个需求,做个练习打字的游戏网站,每个模型跑一遍,所以仅作参考。用的 Claude Code 一次成型,尽量不改,看看最终效果。
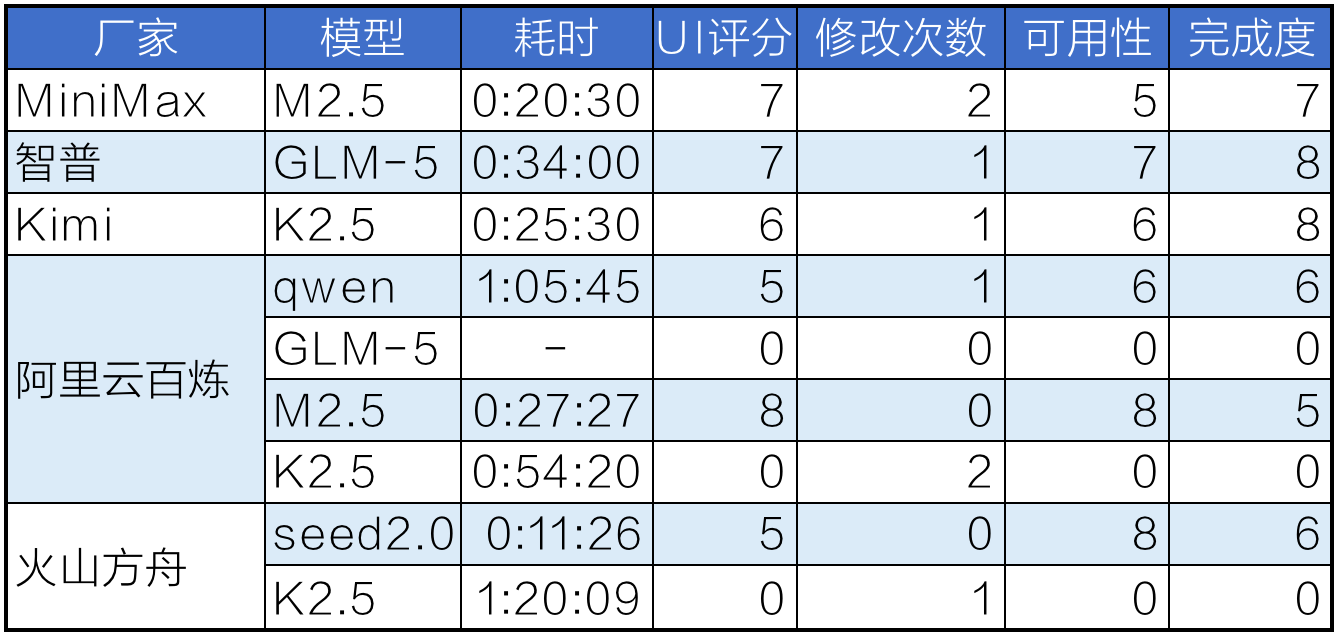
阿里的 GLM 模型中断了三次,我就放弃了。阿里的 K2.5 模型生成出来就是个黑屏,改了两次也什么都不显示,我估计它功能也做了,就是 UI 的问题,但也不能改两次都不显示吧,不知道是谁的锅。
火山方舟的 K2.5 模型,耗时最长,生成后一个打字游戏竟然打不了字。修改吧,又改了得有将近一个小时,打开网页直接报错。感觉非自家模型都不太稳定啊。
耗时,智普、MiniMax 和 Kimi 都差不多。两家多模型的,他们自己的时间差异就很大,看来算力确实不太平衡。尤其是火山方舟的,自家模型11分钟,K2.5 则跑了1小时20分钟,差太多了。
UI 评分,满分10分,我没有用任何 skill,完全是模型自己生成的,都是大同小异的 AI 配色,但也有看着顺眼和不顺眼的,所以完全是主观评分。
修改次数,只要基本能用我就不改,所以改的都是严重到不可用的问题。有趣的是 M2.5 模型在自家平台跑的不怎么样,在阿里却能一次成型,又好看又好用,就是功能差了好多。
可用性,满分10分,主要就是流程是否通顺,再加上用户体验。
完成度,满分10分,就是文档中的需求是否都做了,包括打字功能,评分,成就,统计等。
这两个综合来看,可用性最高的几个,功能都有不少缺失。整体上还是 GLM-5 的成品更好,千问的就比较差了。
说实话,这个测试我觉得也看不出什么东西,因为你换个项目可能评分就不是这么分配的了。所以只能当作是我这一次测试的偏见。要看跑分,还得看我上周写的那些测试集。不过就像我上周说的,你仍然无法从跑分看出实际能力。
所以还得是你自己亲自测,拿你实际的项目或使用场景测,然后主观评断。当然,你使用 AI 的水平也会影响测试结果,但不管怎么说,你就是基于自己实际的使用情况来做判断的,这样对你才最有意义。剩下的就是努力提高自己的能力了。