用 MiniMax 翻唱梅花三弄,结果它竟然给我念经
大模型生成音乐也挺好玩的

上个月 MiniMax 推出了他们最新版的音乐生成模型 Music 2.6,五一这几天我玩了玩,也跟大伙说说体验。
上次玩音乐模型还是 Suno 刚出圈的时候,生成效果一般,泛泛一听还行,仔细听的话总会有各种问题,所以我就忍不住自己去唱。这一转眼两年了,按大模型的成长速度,理论上现在的模型应该要强上很多。
这套音乐模型,主要有三个功能:
- 生成歌词,专门的一个歌词模型,只用来生成带标签的歌词
- 生成音乐,也就是最传统的通过文本描述来生成音乐,可以生成带人声的或纯音乐
- 翻唱,需要提供一段音频,由模型进行翻唱,可以修改歌词和曲风
我买的 MiniMax 的 Token Plan,每天有100首的免费额度,足够一般场景使用了。不过只支持 Token Plan 的 API 调用。
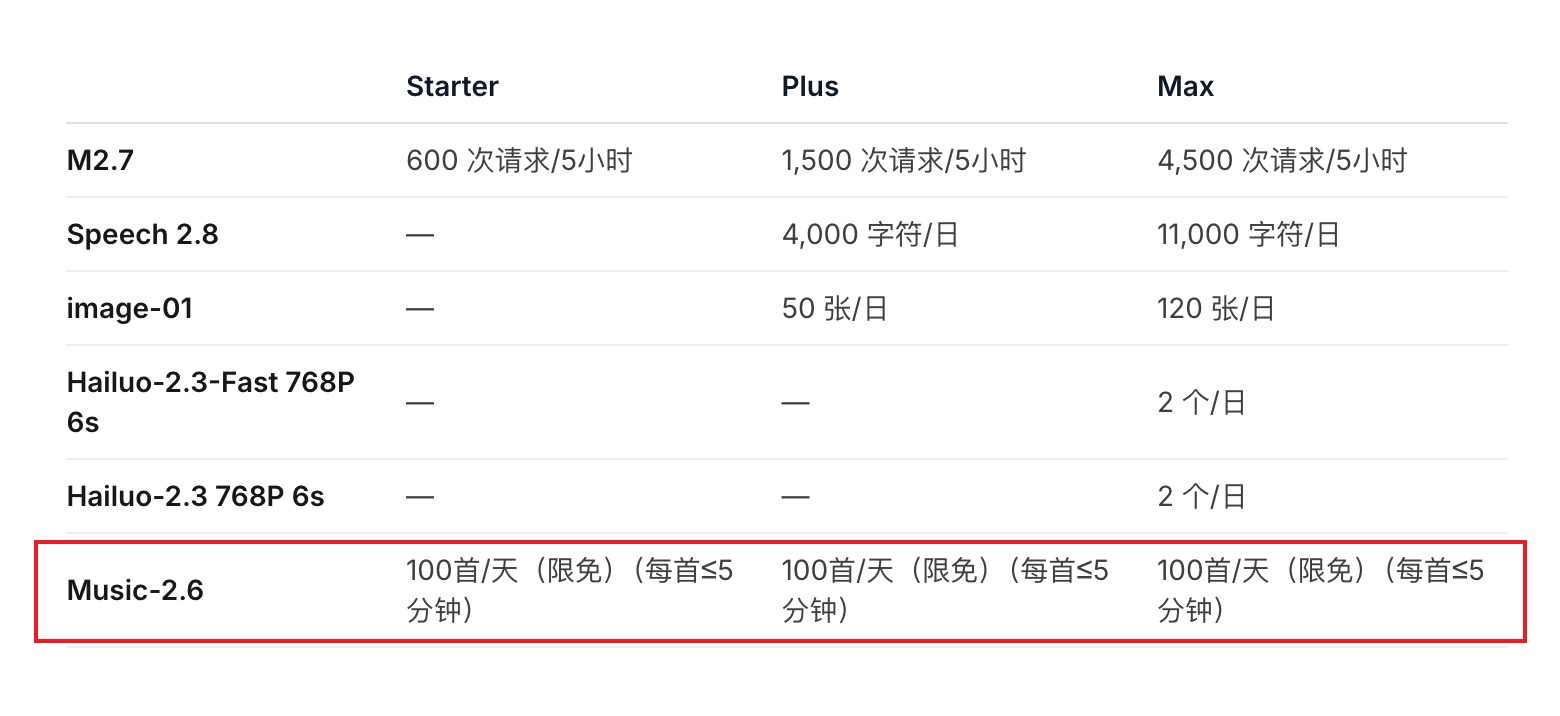
具体的调用方法,把文档发给 AI 它就能给你生成调用的脚本,或者你可以使用 MiniMax 官方提供的命令行工具 mmx,不过它不支持单独生成歌词。官方也提供了一个 skill,minimax-music-gen,它使用的就是 mmx,所以也不支持单独生成歌词。
MMX: https://github.com/MiniMax-AI/cli
我用的是 Claude Code,然后装了 minimax-music-gen,又让 Claude Code 写了一个单独生成歌词的脚本,并把使用发放写入了 minimax-music-gen,这样一个 skill 就都能解决了。
minimax-music-gen: https://github.com/MiniMax-AI/skills
我也做了个视频,演示了下使用过程。
【视频】
两年前的 Suno 生成的人声电子感十足,现在的 MiniMax 生成的人声绝大多数都听不出电子感了。但是节奏的问题似乎还是存在,当然,问题概率比两年前的小很多了。
这个节奏问题我还真不知道应该怎么描述,就是唱歌时,歌词的断句和正常阅读时的不一致,要么是把一段话分成了两个段落唱,要么是把两句话当一句话连起来唱。如果歌词是你听不懂的语言,那就听不出问题,可你要懂,那听着就不太舒服了。
基于这些问题,想生成一首完美的歌还是比较困难的,得抽卡,得碰运气。不过,如果只想要个背景音,随便听听的那种,现有的模型能力已经足够用了。
其中第二首热血励志的《逆风飞翔》,我觉得质量不错,它不像其他歌是完全按着歌词唱的,而是加了很多重复,让整首歌的结构听起来比其他歌要舒服。
【逆风飞翔 音频】
翻唱是2.6的新功能,能把一首歌改成你指定的曲风,或是改成你想要的歌词。我视频里用的是我之前唱的梅花三弄,结果翻唱出来后,它竟然开始念经了,唱了好多阿弥陀佛,给我整得有点儿懵。
我试了好几遍,也换了不同风格,都有阿弥陀佛。但是第二天再试就没了,但还是会有些不明含义的歌词,不知道是不是念的别的经。
最后,我试了试给它一段清唱,看看能不能生成带伴奏的歌,唱了个华建的「沿途有你」,不过生成效果不好,演唱本身的读音节奏音准都有问题,然后加的伴奏也只是一点点简单的钢琴和弦,完全没法听。
其实新版模型对细节的操控能力有很大提升,不过对我们这些音乐外行来说,其实也没那么重要,对专门搞音乐的或许能有很多帮助吧。
对了,想买 MiniMax 的 Token Plan,从下面二维码进入可享9折优惠。
 https://platform.minimaxi.com/subscribe/token-plan?code=sPqOt1Bylt&source=link