咱们来看看 Cloudflare 的这次故障是如何做到不可避免的
你无法消除所有bug,也就无法避免所有故障,但你可以降低影响,也提升可以自己

对软件工程师来说,bug 总是如影随形,你可以想尽一切办法去避免各式各样的 bug,但又总是不可避免的产生新的 bug。而一旦这个 bug 在生产环境显现出来就很可能造成故障,然后其中一定有一部分故障将会成为非常严重的故障,哪怕引发它的只是一个不起眼的小 bug,这一点究竟是如何做到的呢?
前些天 Cloudflare(以下简称CF)发生了一次长达几个小时的严重故障,有人说这导致了半个互联网的瘫痪,虽说有些夸张,但 CF 确实是全球最大的 CDN 和网络安全基础设施供应商之一,传闻承担着超过全球20%的网站流量,其中还包括像微软、Shopify、OpenAI 这样非常知名的互联网公司。所以它的故障影响面绝对是非常广泛的。
CF 当天就给出了一份故障报告,说明了故障原因以及排查过程,报告的地址是:https://blog.cloudflare.com/18-november-2025-outage/
简单地说的,故障的根本原因是一项数据库权限配置变更,导致某个数据库查询结果量大大增加,而处理这个查询结果的代码,没有正确地处理超量的查询结果,使得程序线程崩溃,进而导致了之后一系列的问题。
不可避免的 bug
报告给出了产生问题的这段 Rust 代码:
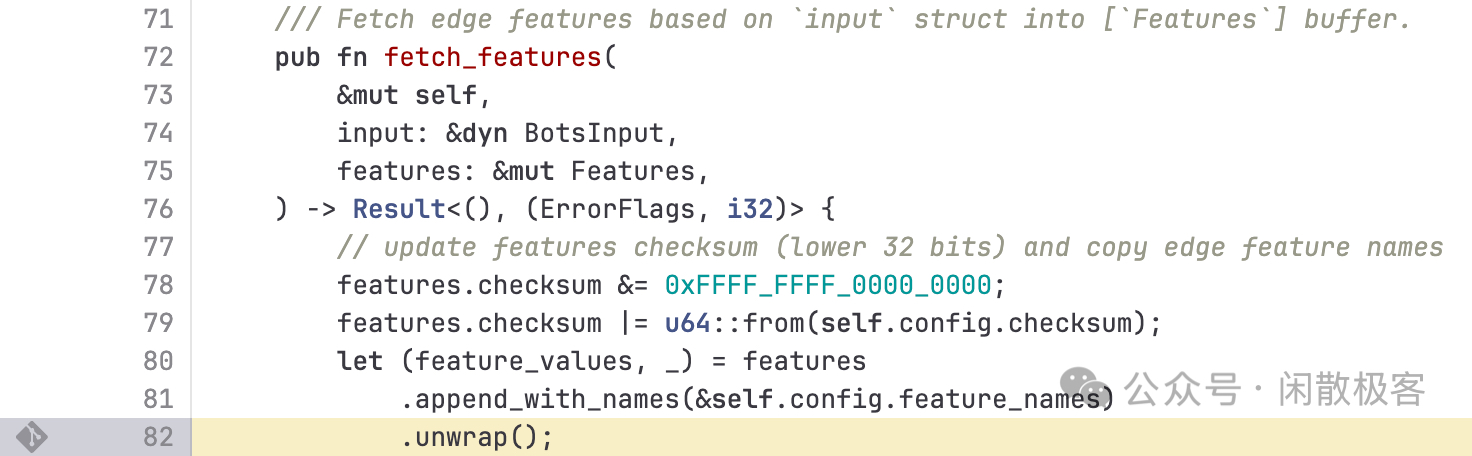
代码中81行的 self.config.feature_names 就是从数据库查询到的结果集,在处理这个结果集的过程中,为了避免结果集数量过大导致的内存占用问题,程序限制了最多只能处理200条,而正常情况下这个结果集大约只有60条。
但是这个200条的限制处理过于粗暴,导致当结果集数量超过200时,append_with_names方法将直接返回一个 Err 对象,而调用 Err 对象的 unwrap 方法则会直接调用一个 panic! 宏,导致当前线程终止。
我们很容易想到,不受限的结果集可能导致内存过量消耗,从而引起一系列的问题,所以需要对结果集数量做一个合理的限制的。但如此粗暴的限制只不过是把内存过分消耗的隐患转化为了一个更容易发现的 panic,但本质上并没有解决结果集过大的问题。
如果你写过几年代码,见过一些老项目,我估计你一定见过类似的情形。为了解决一个问题而引发了另一个问题,甚至只是让问题在代码里倒了几次手,最终还是没有解决。你说这样的代码是如何做到无法避免的。
以我的经验,如果找一些经验丰富的软件工程师来评审这段代码,大概率是能看出问题的。哪怕能看出问题的这个人,他也很可能也会写出这样的问题。但只要他站在评审者的位置上,就会考虑更多的系统健壮性问题,就比较容易发现这类不合理的处理方式。所以我推测出现这样的问题,大概率是代码评审的工作不到位,甚至就没有评审。
我想对于大多数软件工程师来说,对写代码的兴趣是要远远高于对评审的兴趣。评审这件事不但对你的编码经验有一定的要求,还要求你对业务逻辑也得非常清楚。所以在实际工作中,考虑到人力成本问题,评审工作往往不会受到重视,尤其是软件长期平稳运行时,业务蒸蒸日上时。
不论是要提升编码人员的能力,还是要提升评审的质量,都需要增加不少的人力成本,这对一个系统已经长期平稳运行,且业务还在蒸蒸日上的团队来说是不现实的。再加上很多代码都是祖传的,并不是当下团队在当下编写的,那些潜伏已久的隐患就更难以发现了。
寻找这样的隐疾,夸张地说就是大海捞针,能重视新代码的评审就很不错了,很少有人愿意,或者说也不应该,花费大量成本去已经平稳运行的老代码里挑错误。于是,最终那段有问题的代码,就不可避免的出现,并不可避免的长期潜伏下来,又不可避免地在某个时刻显现出来了。
单看代码,更合理的处理方式是给出一个可接受的降级方案同时告警,比如超过200条,就只处理200条,而丢弃多余的数据。如果实在不能接受降级,则应该触发一个高级别的告警,来让相关负责人直接进行干预。
其实如果你看明白了上面的问题,就会发现只要看到了上面那段代码的 panic 日志,理论上应该很快就能定位到问题原因,可从 CF 的故障报告来看,这个定位过程持续了两个小时。
不可避免的故障
为什么有时候一个小 bug 却能引发一个大故障?如今的软件系统越来越复杂了,前些年移动互联网还特别火爆的时候,微服务的概念很流行,它可以让你高效地管理成百上千个相互关联依赖的服务。
我还没有真正意义上地使用过微服务架构,因为我接触的项目最多也就几十个服务吧,也就是刚能够到微服务的门槛,迁移一些微服务的思想过来改善改善我们自己的架构体系也就足够了。而 CF 的体量绝对能算是微服务的顶流了,据说它们内部平台的服务数量早就过千了。
微服务虽然看上去有很多好处,可一旦做起来就会发现,它的运维成本其实很高,你甚至需要专门为它组建一个团队。那么多的服务,运行状态如何监控,日志如何收集展示,链路跟踪如何打通,这都需要从全局考虑。
像 CF 这样的体量,虽然上面代码里的 panic 日志很容易定位到问题的根本原因,但是在一个微服务体系中想要快速找到这个日志,则没有那么容易。
根据故障报告,CF 团队一开始根据自己的经验判断是遭到了 DDos 攻击,所以一开始的排查方向就跑偏了,不知道这一过程耽误了它们多少时间。
看上面那段 Rust 代码的样子,估计它们整个平台中,由 panic 引发的线程崩溃应该不会太少。在这样的故障面前,就算监控系统中有 panic 日志的增长趋势,也很难快速定位到引发根本原因的那个项目,因为受牵连的其它项目也会有相同的趋势,似乎只能人工一个个排查。
这么一看,算上一开始误以为是 DDos 攻击,其实两个小时的时间也不算太长了。要知道故障报告中的这两个小时是从发现问题到定位到问题的,而不是纯粹定位问题过程的时间。在故障一开始,尤其是很多人误以为是遭到 DDos 攻击时,估计是不会有什么有效的排查动作的。
其实一个理想的异常处理流程中,各种错误日志是需要进行分级的,然后为不同级别的错误日志做不同等级的报警。像这次的 panic,因为在平时是根本不会出现的,所以完全可以定为最高等级,也就是只要出现就应该有专人去进行排查,那么第一时间就能发现问题。
这种理想的处理流程,像我这种水平的人是不难想出来的,但是我却从来没见过,因为实际执行中总会有各种阻碍。资源成本问题,组织架构问题,跨部门协作问题,反正这种需要举全员之力,但又没有明显收益的事情,大部分人都不愿意做。
所以在一个庞大的微服务体系中,仅仅是定位一个日志的时间,可能就足以让一个 bug 扩散成一个故障了。既然 bug 不可避免,那故障也同样不可避免。
下个故障早已注定
故障报告中也给出了涉事 SQL:
  SELECT name, type
    FROM system.columns
   WHERE table = 'http_requests_features'
order by name;
在发生故障前这个 SQL 只会查询 default 一个数据库,但是 SQL 中并没有指定这个数据库,所以指定数据库的条件是靠权限来实现的,也就是这个查询操作依赖于权限配置。但很显然,在做权限配置修改时,相关人员并不知道,或者是忽视了这个依赖。
当然,一般来说业务逻辑是不应该依赖数据库权限的,数据库权限是一个非常基础的服务,被业务逻辑依赖就会变得很难更新修改,就像这次故障这样。所以你说像这样的问题如何避免,如果不能在上线前发现,那么以后其实就很难再把它揪出来了,只能等着故障显现了。
CF 在故障报告中也给出了未来的一些改进措施,它们内部的改进措施肯定不止这些。一般来说这些措施会分为两类,一类是针对现有问题的,已经出现过的问题绝对不能再出现,还有一类是如何避免类似问题的,也就是要确保一些潜藏的问题不会出现。
第一类措施相对简单,第二类措施才是重点,比如定位问题后,仍旧花了至少一个小时的时间才解决问题,是否可以增加一些快速回滚的措施,缩短服务恢复时间。
但不管最终实施了哪些措施,仍旧无法发现所有潜在的问题,所以未来故障还会发生。甚至因为各种措施的实施,很多问题确实被解决了,于是系统用又会平稳地运行很长时间,造成相关措施渐渐实效,人们在心理上也不再重视了,于是再过几年,可能又会出现一个很严重的问题,仿佛一切都不可避免。
所以,实际上我们很多措施并不是在于如何避免问题,而是在于当一个不可避免的问题,当一个小概率事故发生的时候,我们如何快速定位问题,如何缩小影响范围,如何缩短故障时间。前些年双十一前,有些大厂,那都是要拔网线甚至拔电源来进行故障处理的演练的。
于是,我们固然不希望自己搞出什么故障,但如果真搞出来了,尤其如果是别人搞出来了,那就认认真真地排查、分析、总结。故障越大,它对你个人的价值也就越大。